

HPSC ADA & legal · मॉड्यूल 33 · स्टैंडर्ड स्तर · 16 min
Heredity, DNA और genes (आनुवंशिकता, DNA और जीन)
HPSC ADA & legal इस chapter से क्या पूछता है
यह chapter सिलेबस की इन लाइनों को पढ़ाता है:
- स्क्रीनिंग टेस्ट (सामान्य) · सामान्य अध्ययन (HPSC स्क्रीनिंग टेस्ट जैसा)
इस मॉड्यूल के HPSC ADA & legal प्रश्न अभी बैंक में जोड़े जा रहे हैं।
HPSC ADA & legal के लिए स्टैंडर्ड स्तर तक। 8 गहरे paragraph पूरे chapter में हैं।
शून्य से शुरू: बच्चे माता-पिता जैसे क्यों दिखते हैं
कोई भी पारिवारिक तस्वीर देखिए। किसी बच्चे की आँखें माँ जैसी हो सकती हैं, बाल पिता जैसे घुँघराले, या क़द दादा-दादी जैसा। कुछ गुण तो एक पीढ़ी छोड़कर फिर दिखते हैं। माता-पिता से बच्चों तक ऐसे गुणों के पहुँचने को आनुवंशिकता (heredity) कहते हैं।
इतिहास के ज़्यादातर समय लोग बस अंदाज़ा लगाते रहे कि यह कैसे होता है। आज हम जानते हैं कि हर जीवित कोशिका में निर्देशों का एक समूह होता है, जैसे पकवानों की किताब, जो शरीर को बताता है कि कैसे बढ़ना और काम करना है। ये निर्देश DNA नाम के रसायन में लिखे होते हैं, और हर एक निर्देश को gene कहते हैं।
बच्चे को इस किताब की एक नक़ल माँ से और एक पिता से मिलती है। इसीलिए बच्चा दोनों का मेल होता है, फिर भी अनोखा होता है। एक कोशिका के पूरे DNA को genome कहते हैं।
यह chapter बताता है कि वैज्ञानिकों ने कैसे पता लगाया कि genes क्या हैं, DNA कैसे बना है, और वह अपनी नक़ल कैसे बनाता है। फिर यह मानव genome के नक़्शे और भारत के अपने genome project को देखता है। ये विचार biotechnology के आगे के हर chapter की नींव हैं।
Mendel की मटर से chromosomes तक
यह सवाल अहम क्यों था? किसान हज़ारों सालों से बेहतर फ़सलें और पशु तैयार करते आए थे, पर नियम कोई नहीं जानता था। नियमों के बिना यह काम धीमी आज़माइश था। आनुवंशिकता के नियम खोजने से यह विज्ञान बन जाता।
Mendel के factors। उन्नीसवीं सदी में Gregor Mendel ने मटर के पौधों पर काम किया और पाया कि गुण तय तरीक़ों से आगे जाते हैं, ऐसी इकाइयों के ज़रिए जिन्हें उन्होंने "factors" कहा। उनके काम को दशकों तक अनदेखा किया गया। इसे 1900 में दोबारा खोजा गया, और वही factors आज genes कहलाते हैं।
factors कहाँ हैं? Mendel नहीं जानते थे कि ये factors कोशिका में कहाँ हैं। फिर वैज्ञानिकों ने देखा कि nucleus के धागे जैसे chromosomes कोशिका विभाजन के समय ठीक वैसे ही बर्ताव करते हैं, जैसा Mendel के factors को करना चाहिए। 1902 में Walter Sutton और Theodor Boveri ने आनुवंशिकता का chromosome सिद्धांत दिया: genes, chromosomes पर होते हैं।
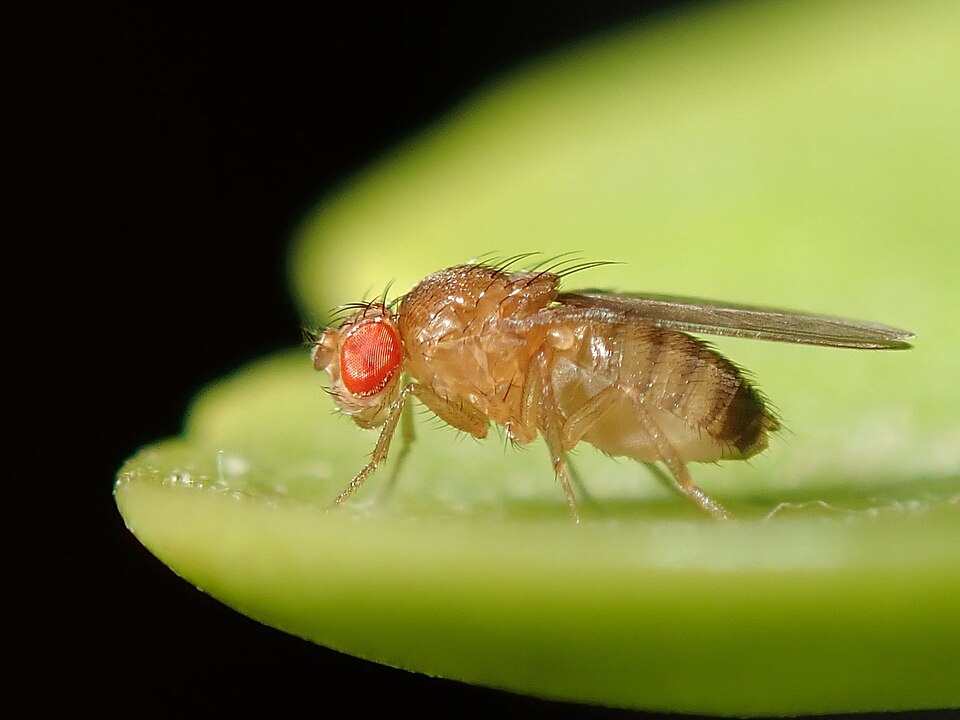
सबूत। T.H. Morgan और उनकी टीम ने इसे फल-मक्खी Drosophila पर जाँचा, जो जल्दी बच्चे देती है और जिसमें कम chromosomes होते हैं। उन्होंने सिद्धांत को पक्का किया और यह भी पाया कि एक ही chromosome पर रहने वाले genes अक्सर साथ-साथ आगे जाते हैं, जिसे linkage कहते हैं।
बड़ी खोज: यह साबित करना कि genes, DNA से बने हैं
chromosomes दो मुख्य पदार्थों से बने हैं: proteins और DNA। लंबे समय तक ज़्यादातर वैज्ञानिक मानते रहे कि genes, proteins में होंगे, क्योंकि proteins कहीं ज़्यादा तरह के होते हैं। तीन मशहूर प्रयोगों ने उन्हें ग़लत साबित किया।
1. Griffith (1928): bacteria के बीच कुछ जा सकता है। Frederick Griffith ने निमोनिया करने वाले bacteria पर काम किया। एक strain (smooth, S) चूहों को मार देता था, जबकि दूसरा (rough, R) नहीं।
जब उन्होंने गर्मी से मारे गए S bacteria को ज़िंदा, बेनुक़सान R bacteria के साथ मिलाया, तो चूहे मर गए, और उनमें ज़िंदा S bacteria मिले। मरे bacteria की किसी चीज़ ने बेनुक़सान bacteria को बदल (transform) दिया था। इसे bacteria का रूपांतरण (transformation) कहा गया।
2. Avery, MacLeod और McCarty (1944): वह चीज़ DNA है। इन वैज्ञानिकों ने "रूपांतरण करने वाले पदार्थ" को शुद्ध किया और उसकी रासायनिक जाँच की। proteins को नष्ट करने वाले enzymes से रूपांतरण नहीं रुका, पर DNA को नष्ट करने वाले enzyme से रुक गया। इसलिए रूपांतरण करने वाला पदार्थ DNA ही होना था।
3. Hershey और Chase (1952): viruses से आख़िरी सबूत। Alfred Hershey और Martha Chase ने bacteriophage इस्तेमाल किया, जो bacteria को संक्रमित करने वाला virus है, और उसके protein और DNA पर अलग-अलग radioactive निशान लगाए। जब virus ने bacteria को संक्रमित किया, तो निशान वाला DNA अंदर गया, जबकि protein का खोल बाहर रहा। नए viruses अंदर बने, इसलिए आनुवंशिक निर्देश DNA में ही होने थे।
यह क्यों अहम था? जब वैज्ञानिकों को पता चल गया कि genes, DNA से बने हैं, तो वे सीधे DNA का अध्ययन कर सके। इससे आनुवंशिकी, patterns के अध्ययन से अणुओं के अध्ययन में बदल गई। आधुनिक biotechnology का हर tool इसी बदलाव से निकला।
दोहरी कुंडली: DNA कैसे बना है और नक़ल कैसे बनाता है
genes के DNA होने की बात समझने के बाद अगला सवाल था: DNA दिखता कैसा है? इसकी बनावट को दो बातें समझानी थीं। इसमें बहुत सारी जानकारी रखनी थी, और हर बार कोशिका बँटने पर इसे ठीक-ठीक अपनी नक़ल बनानी थी।
जवाब (1953)। DNA की X-ray तस्वीरों से James Watson, Francis Crick, Maurice Wilkins और Rosalind Franklin ने पता लगाया कि DNA एक दोहरी कुंडली (double helix) है। यह मुड़ी हुई सीढ़ी जैसा दिखता है। Watson, Crick और Wilkins को 1962 में Nobel पुरस्कार मिला।
सीढ़ी के हिस्से।
- दोनों किनारे की पट्टियाँ शक्कर (sugar) और phosphate से बनी हैं।
- डंडे रासायनिक अक्षरों के जोड़े हैं, जिन्हें bases कहते हैं।
- चार bases हैं: adenine (A), thymine (T), guanine (G) और cytosine (C)।
- A हमेशा T से, और G हमेशा C से जुड़ता है।
इस जोड़ी की वजह से DNA में A की मात्रा हमेशा T के बराबर होती है, और G की C के बराबर। इसे Chargaff का नियम कहते हैं। एक धागे पर अक्षरों का क्रम ही असली जानकारी है, जैसे किसी वाक्य में अक्षरों का क्रम उसका मतलब बनाता है।
DNA अपनी नक़ल कैसे बनाता है? कोशिका के बँटने से पहले सीढ़ी बीच से खुल जाती है, जैसे zip खुलती है। फिर हर पुराना धागा साँचे का काम करता है, और जोड़ी के नियम से एक नया साथी धागा बनता है। नतीजा दो एक जैसी दोहरी कुंडलियाँ होती हैं, जिनमें से हर एक में एक पुराना और एक नया धागा होता है। इसे semiconservative replication कहते हैं, जिसे Watson और Crick ने 1953 में सुझाया।
यह बनावट इतनी अहम क्यों थी? जोड़ी के नियम का मतलब था कि हर धागे में दूसरे धागे की जानकारी है। इसने एक सरल विचार में समझा दिया कि जीवन इतनी सटीकता से अपनी नक़ल कैसे बनाता है। इसी से बाद के वैज्ञानिकों को DNA पढ़ने और बदलने का रास्ता मिला।
gene से protein तक, और genome क्या है
पकवानों की किताब तब तक बेकार है, जब तक कोई खाना न बनाए। वैसे ही DNA अपना काम तभी करता है, जब उसके निर्देशों से proteins बनें। proteins शरीर के मज़दूर हैं: वे मांसपेशियाँ बनाते हैं, oxygen ढोते हैं, कीटाणुओं से लड़ते हैं और रासायनिक क्रियाएँ तेज़ करते हैं।
दो क़दम।
- transcription: nucleus के अंदर एक gene के निर्देश mRNA नाम के संदेशवाहक अणु में नक़ल किए जाते हैं।
- translation: mRNA बाहर कोशिका की एक मशीन ribosome तक जाता है, जो उसे तीन-तीन अक्षर करके पढ़ता है और amino acids को सही क्रम में जोड़कर protein बनाता है।
amino acids 20 तरह के होते हैं। इनके अलग-अलग क्रमों से हमारे शरीर के हज़ारों अलग proteins बनते हैं। DNA के एक अक्षर में बदलाव भी protein को बदल सकता है, और कई आनुवंशिक बीमारियाँ ऐसे ही पैदा होती हैं।
आँकड़ों में मानव genome। मनुष्य के genome में लगभग 3 अरब bases और लगभग 20,000 genes हैं, जो chromosomes के 23 जोड़ों में बँधे हैं। हैरानी की बात है कि genes पूरे DNA का सिर्फ़ लगभग 1% हैं। बाक़ी में genes को चालू और बंद करने वाले switch, और लंबे हिस्से हैं जिनकी भूमिका पर अभी शोध चल रहा है।
nucleus के बाहर DNA। कोशिका के ऊर्जा बनाने वाले छोटे हिस्से, mitochondria, का अपना छोटा DNA होता है। यह सिर्फ़ माँ से आगे जाता है, इसलिए वैज्ञानिक इससे वंश और इंसानों के प्रवास का पता लगाते हैं।
पूरी किताब पढ़ना: Human Genome Project
जब वैज्ञानिक DNA के छोटे टुकड़े पढ़ने लगे, तो एक साहसी विचार आया: क्यों न मानव genome के सारे 3 अरब अक्षर पढ़े जाएँ? इससे हर मानव बीमारी के अध्ययन के लिए एक संदर्भ नक़्शा मिल जाता। यही विचार Human Genome Project (HGP) बना।
कब और किसने? HGP 1990 से 2003 तक चला। यह अपने 2005 के लक्ष्य से दो साल पहले पूरा हुआ, और इसका अनुमानित ख़र्च 15 साल में लगभग $3 अरब था। अमेरिका, ब्रिटेन, फ़्रांस, जर्मनी, जापान और चीन के लगभग 20 केंद्रों ने एक अंतरराष्ट्रीय consortium के रूप में साथ काम किया।
विज्ञान को दिशा देने वाले नियम। 1996 के Bermuda सिद्धांतों के तहत project ने अपना data जल्दी और मुफ़्त जारी किया, ताकि दुनिया का कोई भी वैज्ञानिक उसे इस्तेमाल कर सके। 1990 में शुरुआत से ही इसने निजता और भेदभाव जैसे आनुवंशिकी के नैतिक, क़ानूनी और सामाजिक मुद्दों (ELSI) पर एक कार्यक्रम को भी पैसा दिया।
क्या यह सच में पूरा था? 2003 का क्रम "लगभग पूरा" था, पर कठिन हिस्सों में अब भी ख़ाली जगहें थीं। पहला सच में पूरा मानव genome, हर chromosome के एक सिरे से दूसरे सिरे तक, Telomere-to-Telomere (T2T) consortium ने 31 मार्च 2022 को घोषित किया।
भारत के लिए यह क्यों अहम है? HGP का संदर्भ ज़्यादातर कुछ ही लोगों से बना था, जो मुख्य रूप से भारतीय मूल के नहीं थे। आनुवंशिक बीमारियाँ और दवाओं का असर अलग-अलग आबादियों में अलग होता है। इसीलिए भारत को अपना genome data चाहिए था, जिसे अगला हिस्सा समझाता है।
भारत का अपना नक़्शा: GenomeIndia project
भारत दुनिया के सबसे ज़्यादा आनुवंशिक विविधता वाले देशों में है, जहाँ कई समुदायों में सदियों से ज़्यादातर अपने ही समूह में शादी होती आई है। इसका मतलब है कि कुछ आनुवंशिक बीमारियाँ कुछ समूहों में आम हैं, पर बाक़ी जगह कम। दूसरी आबादियों से बना संदर्भ इन अंतरों को चूक सकता है।
क्या किया गया? जैव प्रौद्योगिकी विभाग (DBT) के नेतृत्व वाले GenomeIndia project के तहत वैज्ञानिकों ने अलग-अलग भारतीय आबादियों के लोगों के पूरे genome पढ़े। 9 जनवरी 2025 को नई दिल्ली में Genome India Data Conclave में 10,000 पूरे genomes का dataset जारी किया गया।
data कहाँ रखा है? data को Indian Biological Data Centre (IBDC) में रखा गया है। शोधकर्ता Framework for Exchange of Data Protocols (FeED) के ज़रिए पहुँच माँग सकते हैं, जो 2021 के Biotech-PRIDE दिशानिर्देशों के तहत काम करता है। इन नियमों का मक़सद शोध के लिए data बाँटना और साथ ही नमूने देने वाले लोगों की निजता बचाना है।
यह क्यों अहम है?
- बेहतर जाँच: डॉक्टर बता सकते हैं कि कोई gene बदलाव भारत में आम और बेनुक़सान है, या दुर्लभ और बीमारी पैदा करने वाला।
- बेहतर दवाएँ: दवा की मात्रा और चुनाव को भारतीय मरीज़ों के असर के हिसाब से मिलाया जा सकता है।
- शोध और उद्योग: भारतीय start-ups और labs भारतीय मरीज़ों के लिए बने आनुवंशिक tests बना सकते हैं।
आगे क्या? अधिकारियों ने भविष्य में कहीं बड़े लक्ष्य की बात की है। बड़े datasets से सटीकता बढ़ेगी, पर इससे मज़बूत data protection और ज़रूरी हो जाता है।
पिछले वर्षों के प्रश्न
यह हिस्सा आपके चुने हुए exam में इस chapter से पूछे गए असली सवाल दिखाता है। हर सवाल official प्रश्नपत्र से शब्दशः लिया गया है, साल और paper के साथ, ताकि आप देख सकें कि यह topic असल में कैसे पूछा जाता है।
सवाल UPSC और BPSC के official प्रश्नपत्रों से जुटाए जा रहे हैं। हर सवाल मूल प्रश्नपत्र से मिलाने के बाद यहाँ दिखेगा।
तेज़ दोहराव
- Mendel का काम 1900 में दोबारा खोजा गया। Sutton और Boveri (1902) ने chromosome सिद्धांत दिया, और Morgan ने Drosophila से उसे पक्का किया।
- Griffith (1928) ने रूपांतरण दिखाया, Avery–MacLeod–McCarty (1944) ने दिखाया कि वह DNA है, और Hershey–Chase (1952) ने phage से इसे पक्का किया।
- दोहरी कुंडली (1953) में bases A, T, G और C हैं, जिनके जोड़े A–T और G–C हैं। नक़ल semiconservative है।
- DNA → mRNA → protein का काम transcription और translation से होता है, 20 amino acids से।
- मानव genome में लगभग 3 अरब bases, ~20,000 genes और 23 chromosome जोड़े हैं। genes, DNA का लगभग 1% हैं, और mitochondria का DNA माँ से आता है।
- HGP 1990 से 2003 तक चला, और T2T ने 2022 में genome पूरा किया। GenomeIndia (DBT) ने 9 जनवरी 2025 को 10,000 genomes जारी किए, जो IBDC में हैं।